TLDR;
Este artigo representa meu pensamento sobre o futuro (na verdade, o presente) do code review, em que a leitura pura de código está rapidamente perdendo relevância. Proponho analisar os sinais que o código emite como sensores, à semelhança de um painel de instrumentos, em vez de depender apenas da leitura linear do código. Esses sensores podem identificar rapidamente algo que merece mais atenção e orientar o aprofundamento.
Texto escrito com minhas ideias e auxílio da IA na editoração.
Onde a revisão se perde
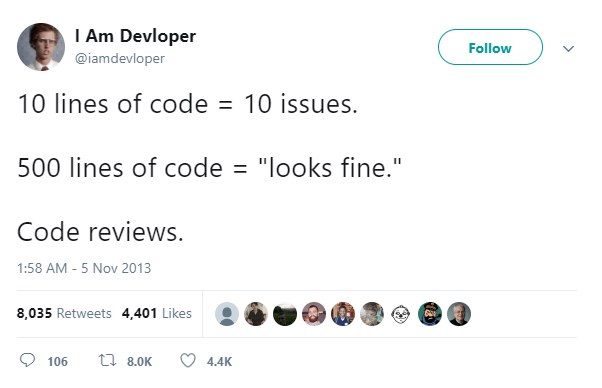
Em code review, frequentemente somos rigorosos onde a revisão é cognitivamente barata e superficiais justamente quando o risco pode ser maior.
Com programação agêntica, essa assimetria deixa de ser uma curiosidade do processo e passa a ser um problema operacional. Produzir código está ficando mais barato. Entender contexto, estimar impacto e julgar trade-offs continua caro.
É por isso que acredito que o code review precisa mudar de altitude. Não para remover o reviewer, nem para delegar o julgamento à IA, mas para dar ao humano uma visão melhor de onde sua atenção realmente importa.
Tenho aplicado essa ideia de forma concreta e visto bons resultados: quando a revisão começa por sinais sobre intenção, risco e estrutura, fica mais fácil chegar às partes do diff que merecem investigação profunda. O código continua sendo a evidência final. A diferença é que não precisamos tratá-lo como uma sequência uniforme de linhas.
O gargalo não é mais produzir código
Ferramentas baseadas em LLM já escrevem funcionalidades, testes, migrations, integrações, refatorações e correções em uma velocidade difícil de imaginar poucos anos atrás. Isso não garante qualidade. Significa que o custo marginal de produzir uma mudança caiu.
A capacidade humana de revisão não acompanhou a mesma curva. Ela continua limitada por tempo, atenção, conhecimento do domínio, familiaridade com a codebase e capacidade de sustentar contexto na memória.
O resultado é previsível: quanto maior o PR, mais energia é consumida apenas para reconstruir mentalmente o que aconteceu. A profundidade da análise passa a ser limitada não pelo risco da mudança, mas pela capacidade cognitiva disponível para revisá-la.
Pedir que reviewers leiam mais código, mais rápido e com a mesma profundidade não resolve essa equação. Eliminar a revisão humana também não. O caminho que tenho explorado é usar IA para tornar explícitos os pontos que precisam de julgamento humano.
Review orientado por sinais
O diff não é só uma coleção de linhas alteradas. Ele produz sinais sobre propriedades importantes da mudança: se ela corresponde ao que foi pedido, se preserva opções futuras, se respeita limites arquiteturais, se pode ser verificada e se deixa o sistema mais simples ou mais frágil de evoluir.
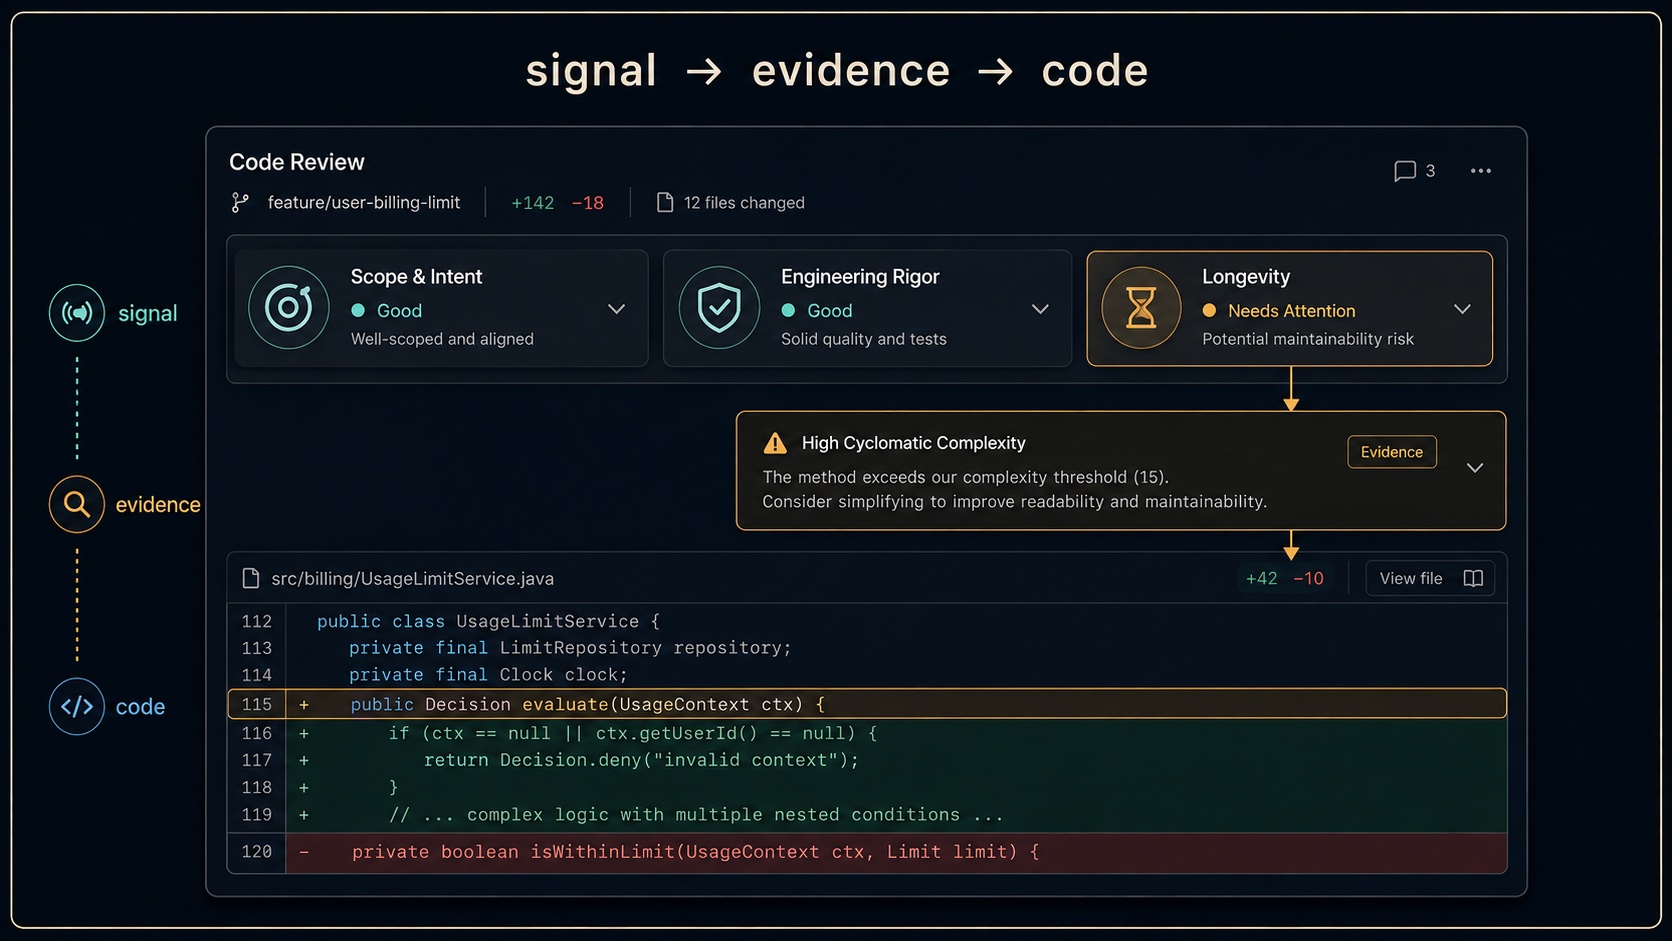
Esses sinais não são uma nota automática de qualidade e não devem virar autoridade algorítmica. São hipóteses acompanhadas de evidência: algo que merece ser visto por uma pessoa, com contexto suficiente para concordar, discordar ou investigar.
Um sinal também não é um bloqueio. Regras mecânicas e maduras — por exemplo, testes obrigatórios, uma política de segurança ou uma convenção de lint — podem e devem ser verificadas automaticamente. O sinal entra onde a regra não alcança: ele ajuda a revelar uma mudança cujo impacto, intenção ou trade-off ainda pede interpretação.
Um exemplo simples:
Longevity — atenção necessária O PR introduz uma segunda implementação de uma regra que antes estava centralizada. Mudanças futuras podem exigir sincronização em múltiplos pontos.
O valor desse comentário não está no rótulo. Está no caminho que ele abre para a investigação: a regra é realmente a mesma? Há uma razão legítima para separá-la? A duplicação é temporária? Que custo ela cria para a próxima mudança?
Do sinal à linha de código
Penso nisso como instrumentação. Um piloto não inspeciona cada componente do motor durante todo o voo. Ele usa instrumentos para perceber estados relevantes e investiga mais a fundo quando algo chama atenção.
O reviewer precisa do mesmo tipo de zoom variável:
sinal → evidência → arquivo → método → linha de código
Em vez de começar por uma leitura linear e uniforme de todo o diff, a revisão pode começar por uma visão ampla de intenção, comportamento, risco e impacto estrutural. Quando um sinal aparece, o reviewer desce até o código e exerce o julgamento que nenhuma classificação substitui.
Isso não é revisar menos. É investir profundidade onde ela tem maior retorno.
Guardrails antes; observação depois
Agentes precisam de orientação antes de implementar: convenções do repositório, padrões de arquitetura, restrições de domínio e instruções como as que registramos em AGENTS.md. Esses guardrails reduzem erros previsíveis e deixam claro o que é esperado.
Essa orientação precisa ser conhecimento institucional recuperável, não uma coleção de lembranças espalhadas entre pessoas, chats e documentos antigos. Padrões de engenharia, decisões arquiteturais e critérios de qualidade funcionam melhor quando têm uma fonte clara, são mantidos junto do trabalho e podem ser consultados tanto por quem implementa quanto por quem revisa.
Mas orientação não garante resultado. Depois da implementação, uma análise independente precisa observar o que efetivamente apareceu no diff, sem depender apenas da narrativa do agente que produziu a mudança.
São responsabilidades complementares:
- antes: como esperamos que a mudança seja construída;
- depois: o que foi construído e quais sinais ela produz;
- por fim: a decisão humana sobre aceitar, investigar, comentar ou pedir refatoração.
A IA ajuda a enxergar. A responsabilidade de engenharia permanece humana.
Feedback contínuo, não apenas o PR final
Os sinais não precisam esperar a abertura de um pull request. Alguns podem aparecer enquanto a mudança ainda está sendo construída, outros no ambiente local, no CI, em uma nova rodada de revisão ou até na especificação que antecede o código.
Isso não elimina o momento de revisão. Ele passa a ser o lugar onde evidências acumuladas se encontram e o julgamento decide se a mudança está pronta, precisa de investigação adicional ou deve voltar para iteração. Quanto mais cedo um sinal confiável aparece, menor é o custo de corrigi-lo — e mais atenção humana sobra para o que realmente não pode ser automatizado.
A direção desta série
Nos próximos textos, vou explorar esses sinais em três grupos.
- Scope & Intent: Scope alignment e Reversibility.
- Engineering Rigor: Defensive programming, Architecture & design, Change verifiability e Scale & performance.
- Longevity: Maintainability, Observability, Consistency e Automation surface.
Não são uma checklist para aprovar ou reprovar PRs. São lentes para fazer perguntas melhores sobre uma mudança concreta e encontrar a evidência que sustenta uma decisão.
Para mim, esse é o futuro mais promissor do code review: não tentar ler cada linha com a mesma profundidade, nem ensinar uma máquina a dizer LGTM, mas usar IA para tornar sinais relevantes mais difíceis de ignorar.
O objetivo é simples: tornar riscos e decisões importantes mais visíveis antes que cheguem à produção.
Leituras relacionadas
- Orchestrating AI Code Review at scale — Cloudflare: descreve uma arquitetura de agentes especializados para revisão em CI, com coordenação, contexto de repositório e re-revisões incrementais.
- How Cloudflare enforces engineering standards using AI — Cloudflare: apresenta um sistema de padrões de engenharia governados, consultados por agentes de revisão de código, especificações e incidentes.
- Clean Code pra Agentes de IA — AkitaOnRails: relaciona estrutura de código, nomes pesquisáveis, contexto e testes com a capacidade de agentes navegarem e mudarem uma codebase com segurança.
- The End of Code Review: Coding Agents Supersede Human Inspection — Martin Monperrus: apresenta a tese de que agentes podem assumir os objetivos tradicionais do code review com menor custo e maior throughput.
- The End of Human Code Review — Macroscope: defende revisão contínua por agentes, com critérios de política e risco para escalonar casos a pessoas.